AI Müşteri Hizmetlerinde Kalite Güvencesi: Konuşma Analitiği, Değerlendirme ve İnsan Denetimi Rehberi
Müşteri hizmetlerinde yapay zeka artık bir deneme projesi değil, günlük operasyonun parçası. Bu noktada tartışma "bot kullanalım mı" sorusundan "botun ürettiği sonucun kalitesini nasıl ölçeriz" sorusuna kaydı. Çünkü bir chatbot ya da AI ses ajanı yüzlerce görüşmeyi sorunsuz kapatırken birkaç görüşmede yanlış bilgi verebilir, yanlış işlem başlatabilir veya müşteriyi gereksiz yere oyalayabilir. Kalite güvencesi tam olarak bu görüşmeleri görünür kılmak için vardır.
Bu rehberde uygulanabilir bir kalite güvencesi sistemi kurmayı anlatıyoruz: hangi sonuçları ölçeceğiniz, hangi görüşmeleri örnekleyeceğiniz, kalite rubriğini nasıl yazacağınız, otomatik skor ile insan değerlendirmesini nasıl birleştireceğiniz ve 30 günlük bir pilotu nasıl yürüteceğiniz.
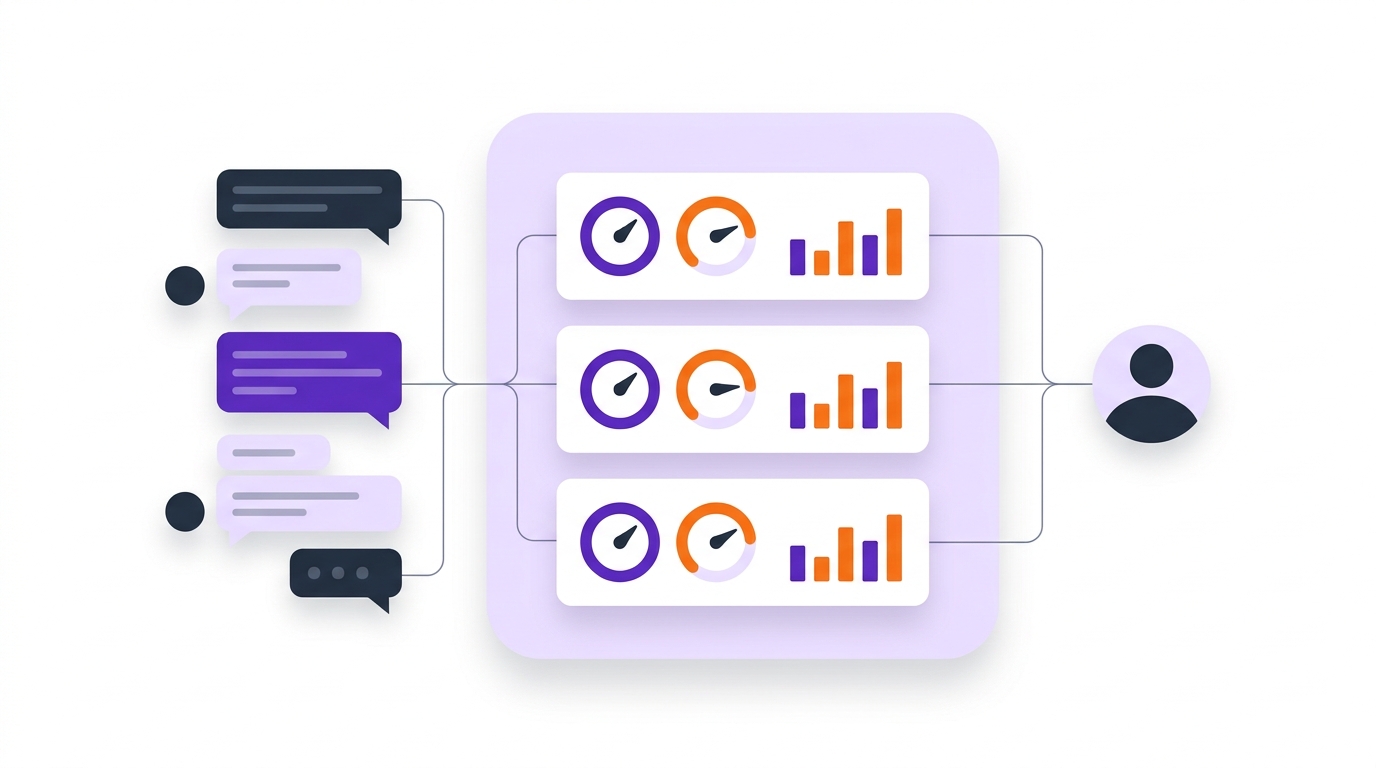
Kalite güvencesinin hedefi: üç ayrı sonuç
Kalite güvencesini tek bir KPI'a indirgemek, bu alanda en sık yapılan hata. Sağlıklı bir çerçeve üç sonucu ayrı ayrı izler:
- Müşteri sonucu: Müşteri sorununa çözüm buldu mu, tekrar yazmak zorunda kaldı mı, ne kadar efor harcadı, memnun kaldı mı?
- Operasyon sonucu: Görüşme ne kadar sürede çözüldü, ilk temasta çözüldü mü, kaç kez devredildi, ekip üzerinde ne kadar yük oluşturdu?
- Risk sonucu: Yanlış bilgi verildi mi, politika dışına çıkıldı mı, hassas veri gereğinden fazla paylaşıldı mı, geri alınamaz bir işlem başlatıldı mı?
Bu üç eksen birbirinin yerine geçmez. Yüksek çözüm oranı, yüksek hata oranını gizleyebilir; düşük hata oranı ise müşterinin işini görmeyen bir botu iyi gösterebilir. Panelde bu üçünü ayrı kartlar olarak görmek, yorum hatasını en baştan engeller.
Kapsam ve örnekleme: her görüşmeyi değil, doğru görüşmeyi okuyun
Tüm görüşmeleri insanla okumak ölçeklenmez; yalnız otomatik skorla yetinmek de körlük yaratır. Pratik çözüm katmanlı örnekleme.
Örneklem oluştururken şu kırılımları gözetin:
- Kanal: WhatsApp, Instagram, web sohbeti, e-posta ve sesli arama aynı rubrikle değerlendirilmez; sesli görüşmede ton ve kesinti, yazılı görüşmede netlik ve yönlendirme öne çıkar.
- Niyet: Sipariş durumu, iade, faturalama, teknik destek ve şikayet gibi niyetler risk açısından farklıdır.
- Risk düzeyi: Ödeme, hesap değişikliği ve hassas veri içeren görüşmeler ayrı ve daha yoğun örneklenir.
- Temsilci türü: Yalnız bot, bot ve insan devri, yalnız insan görüşmeleri ayrı gruplarda izlenir; aksi halde botun performansı insanın performansına karışır.
- Dil ve segment: Farklı dillerde ve farklı müşteri segmentlerinde doğruluk farklılaşabilir.
Örneklemi iki parçaya ayırın: rastgele seçilen bir taban örneklem (genel eğilimi görmek için) ve kurallarla seçilen kritik vakalar (düşük güvenle kapanan, tekrar temasa dönen, eskalasyonla biten, olumsuz duygu tespit edilen görüşmeler). Kritik vakaların tamamı okunur; taban örneklem ise haftalık sabit bir sayıda tutulur.
Kalite rubriği: tek skor değil, ayrıştırılabilir kriterler
Rubrik, kalite güvencesinin omurgasıdır. İyi bir rubrik "iyi görüşme" tanımını ölçülebilir parçalara böler ve her parçayı davranış düzeyinde tarif eder. Müşteri hizmetleri için aşağıdaki kriterler iyi bir başlangıçtır:
- Doğruluk: Verilen bilgi kaynakla uyumlu mu? Fiyat, süre, stok ve politika gibi olgusal alanlarda hata var mı?
- Politika ve bilgi tabanı uyumu: Yanıt, tanımlı iş kuralları ve onaylı bilgi tabanıyla çelişiyor mu? Bilgi tabanında olmayan bir konuda uydurma yapılmış mı?
- Eksiksizlik: Müşterinin sorusunun tamamı yanıtlandı mı, yoksa yalnız ilk kısmı mı?
- Ton ve dil: Üslup marka diline uygun mu, müşteriye tepeden bakmıyor mu, gereksiz uzun mu?
- Araç ve veri kullanımı: Sipariş, hesap veya kayıt bilgisi doğru sistemden mi çekildi? Gereksiz veri istendi mi?
- Çözüm: Müşterinin asıl işi gerçekten çözüldü mü, yoksa görüşme "yönlendirdim" diyerek mi kapandı?
- İlk temasta çözüm (FCR): Aynı konu kısa süre içinde tekrar geldi mi?
- Devir kalitesi: İnsana aktarımda özet, geçmiş ve yapılan işlemler taşındı mı? Müşteri kendini tekrar anlatmak zorunda kaldı mı?
- Güvenlik ve uyum: Kimlik doğrulama yapıldı mı, hassas veri maskelendi mi, yetkisiz işlem engellendi mi?
Her kriteri 1–5 arası bir ölçekle ve her puanın ne anlama geldiğini tek cümleyle yazın. Örneğin doğrulukta 5 "kaynakla birebir uyumlu", 3 "küçük eksik ama yanıltıcı değil", 1 "müşteriyi yanlış yönlendiren hata" gibi tanımlanmalıdır. Tanımsız ölçek, değerlendiriciler arasında tutarsızlık üretir.
Rubriğe bir de kritik hata listesi ekleyin: yanlış tutar bildirmek, yetkisiz iade başlatmak, başka müşterinin verisini paylaşmak gibi maddeler puan ortalamasından bağımsız olarak görüşmeyi başarısız işaretler. Ortalama skorlar kritik hataları gizlemesin.
Değerlendirme akışı: otomatik ön skor, insan kararı
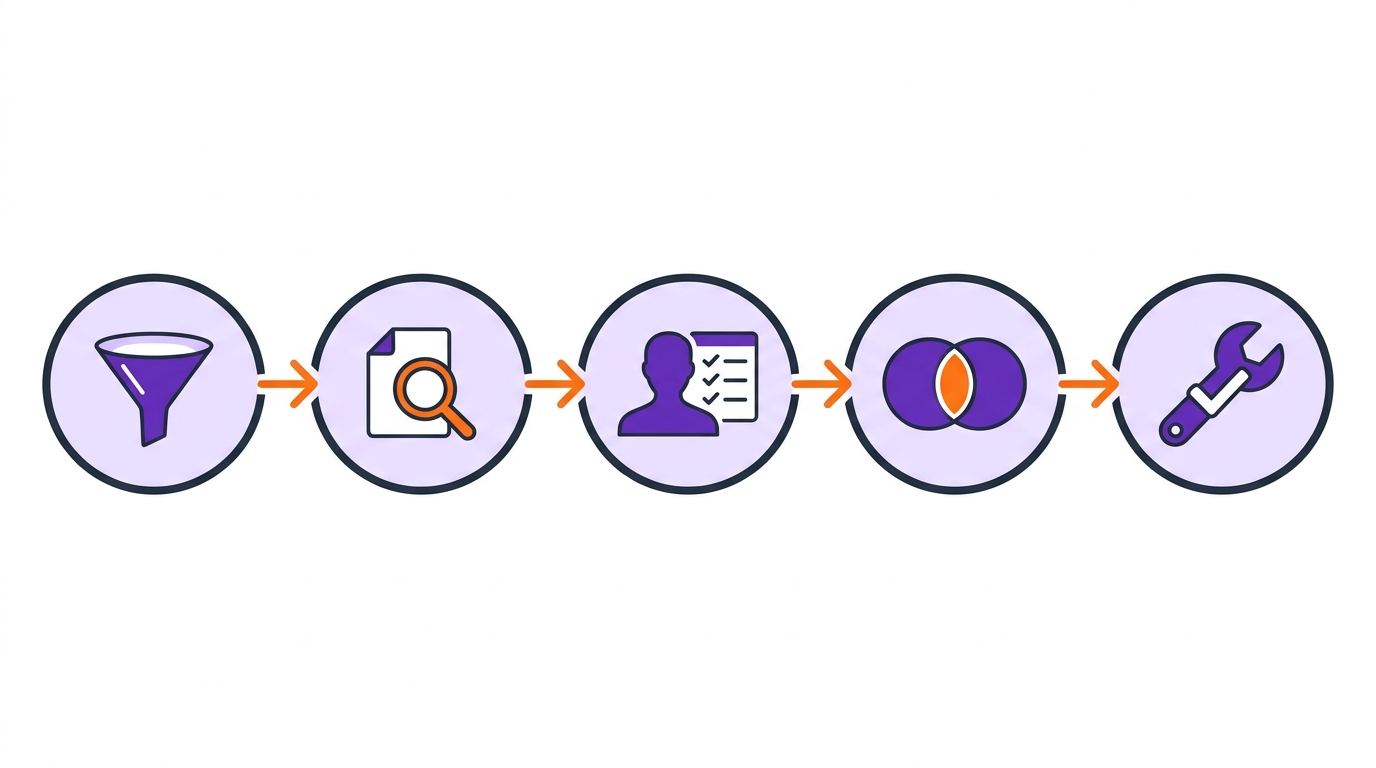
Konuşma analitiği hacmi taramak için güçlü bir araç, ama tek başına nihai hakem olmamalı. Önerilen akış üç katmanlıdır:
- Otomatik ön değerlendirme: Transkript üzerinden niyet, duygu, anahtar ifadeler, politika ihlali sinyalleri ve rubrik kriterlerine göre bir ön skor üretilir. Bu katman tüm görüşmeleri tarar ve riskli olanları işaretler.
- İnsan incelemesi: Örneklem ve işaretlenen görüşmeler kalite uzmanı tarafından rubrikle puanlanır. Uzman otomatik skoru görmeden puanlarsa kör değerlendirme elde edilir ve gerçek sapma ölçülebilir.
- İtiraz ve kalibrasyon: Otomatik skor ile insan skoru arasındaki farklar haftalık olarak incelenir. Fark sistematikse rubrik, bilgi tabanı veya analiz modeli güncellenir; tek tek vakalarda ise değerlendirici notu yazılır.
Bu akışın en değerli çıktısı tek bir skor değil, farkın kendisidir. Otomatik analiz sürekli yüksek, insan sürekli düşük puan veriyorsa ya analiz fazla iyimserdir ya da rubrik fazla katı. İkisi de düzeltilebilir bir sinyaldir.
Supsis tarafında bu akışı kurarken chatbot görüşmeleri, canlı destek görüşmeleri ve sesli ajan çağrıları aynı panelde toplanabildiği için örneklem seçmek ve karşılaştırmak kolaylaşır. Supsis chatbot kendi bilgi kaynaklarınızdan öğrenecek şekilde yapılandırılabiliyor ve karmaşık taleplerde görüşme geçmişiyle canlı temsilciye aktarılabiliyor; bu da devir kalitesini ayrı bir kriter olarak ölçmeyi mümkün kılıyor.
İnsan devri ve onay katmanı: kaliteyi şansa bırakmamak
Kalite güvencesinin en kritik kararı, botun nerede duracağıdır. Devir kuralları yazılı olmalı ve botun akışına gömülmelidir. Pratikte üç eşik işe yarar:
- Güven eşiği: Modelin yanıt güveni belirli bir düzeyin altındaysa bot tahmin etmek yerine devreder.
- Konu eşiği: Ödeme, iade, hesap değişikliği, adres güncelleme, hukuki tehdit, sağlık ve güvenlik gibi konular doğrudan insana gider.
- Duygu eşiği: Tekrarlanan temas, olumsuz duygu veya yükselen ton tespit edilirse görüşme öncelikli olarak insana aktarılır.
Devir anında müşteriye "kontrol edip döneceğim" demek yerine ne olduğunu ve ne zaman dönüleceğini söylemek gerekir. İnsan tarafında ise görüşmenin özeti, müşterinin daha önce anlattıkları ve botun yaptığı işlemler hazır olmalıdır. Supsis'te canlı destek görüşmeleri aynı panelde aktığı için canlı destek tarafına geçen temsilci bu geçmişi hazır bulur. Aksi halde devir, kaliteyi düşüren bir deneyime dönüşür.
Geri alınamaz işlemler için ayrı bir onay katmanı kurun: bot işlemi hazırlar, insan onaylar. Bu hem hızı korur hem de yanlış iadenin veya yanlış hesap değişikliğinin önüne geçer. Sesli kanalda da benzer bir yapı gerekir; AI ses ajanı çağrı kaydı ve dökümü, çağrı analizi ve insan aktarımı ile bu denetimi destekler.
Dashboard: az ama doğru metrik
Kalite paneli kalabalık olmak zorunda değil. Aşağıdaki metrikler üç sonuç eksenini birlikte görmek için yeterlidir:
- Çözüm oranı ve ilk temasta çözüm (FCR)
- CSAT ve tekrar temas oranı
- Ortalama yanıt süresi, çözüm süresi ve SLA içinde kapanan görüşme oranı
- İnsana devir ve eskalasyon oranı
- Yanlış aksiyon ve politika ihlali sayısı
- Kanal, niyet ve segment bazında dağılım
Metrikleri tek bir toplam sayı olarak değil, kırılımlı gösterin. Toplam çözüm oranı yüzde 80 görünürken iade niyetinde yüzde 40 olabilir; bu fark operasyon kararını tamamen değiştirir. Kalite kayıtlarını dinamik tablolarda tutmak, görüşme bazlı puanları ve düzeltici aksiyonları aynı yerde izlemeyi kolaylaştırır: Supsis tablolar.
Haftalık kalite döngüsü
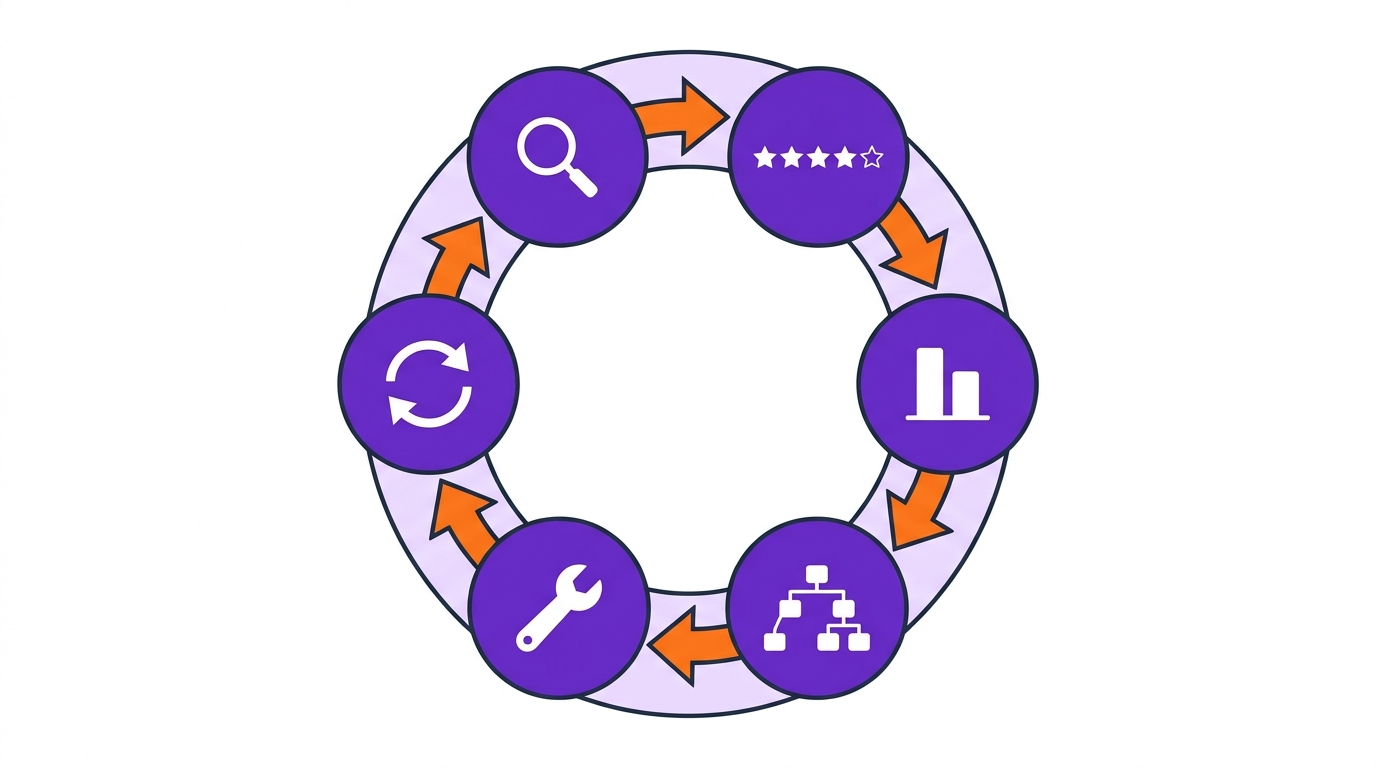
Kalite güvencesi tek seferlik bir kurulum değil, döngüdür. Haftalık ritmi şu altı adıma oturtun:
- Örnekle: Rastgele taban örneklemi ve kritik vakaları seç.
- Puanla: Rubrikle, mümkünse kör değerlendirme yap.
- Karşılaştır: Otomatik skor ile insan skorunu yan yana koy.
- Kök nedeni bul: Hatalar bilgi tabanı eksiğinden mi, akış tasarımından mı, modelin yorumundan mı kaynaklanıyor?
- Düzelt: Bilgi tabanını, akışı, promptu veya devir eşiğini güncelle.
- Regresyon testi yap: Düzeltmenin eski doğru davranışları bozmadığını aynı test senaryolarıyla kontrol et.
Bu döngü 45–60 dakikalık bir toplantıya rahatça sığar. Önemli olan toplantının bir skor okuma değil, bir düzeltme toplantısı olmasıdır. Her hafta en az bir somut değişiklik çıkmalıdır.
Veri yönetişimi: kalite ölçerken mahremiyeti korumak
Kalite çalışması, müşteri verisinin en yoğun kullanıldığı alanlardan biridir. Bu nedenle ölçüm sistemi baştan mahremiyet kurallarıyla tasarlanmalıdır:
- Değerlendirme ekranlarında kart ve kimlik numarası gibi alanlar maskelenir.
- Kalite kayıtlarında yalnız değerlendirme için gereken alıntı tutulur; tam transkript saklanacaksa saklama süresi tanımlanır.
- Erişim rol bazlıdır; kalite uzmanı, operasyon yöneticisi ve geliştirici farklı kapsamlar görür.
- Değerlendirme notlarına müşteri verisi kopyalanmaz; gerekiyorsa kayıt referansı kullanılır.
- Sesli görüşmelerde kayıt ve döküm süreçleri, yürürlükteki mevzuata ve şirket politikanıza uygun biçimde yürütülür.
30 günlük pilot planı
Kalite güvencesini tüm operasyona yaymadan önce tek bir kanalda veya tek bir niyet grubunda pilot yapın.
1. hafta — Rubrik ve başlangıç ölçümü. Kriterleri yazın, ölçek tanımlarını netleştirin, 30–50 görüşmelik bir başlangıç ölçümü alın. Bu ölçüm "iyi" veya "kötü" değil, referans noktasıdır.
2. hafta — Örnekleme ve otomatik ön skor. Örneklem kurallarını uygulayın, otomatik analizle ön skorları üretin, kritik hata listesini test edin.
3. hafta — Kalibrasyon ve düzeltme. İnsan ve otomatik skorları karşılaştırın, en sık görülen üç hata tipini belirleyin, bilgi tabanı ve akışta ilk düzeltmeleri yapın.
4. hafta — Karşılaştırma ve karar. Kanal ve segment bazında sonuçları karşılaştırın; rubriği, eşikleri ve devir kurallarını güncelleyin. Yaygınlaştırma kararını bu verilerle verin.
Pilotun çıktısı bir rapor değil, çalışan bir sistem olmalıdır: güncellenmiş rubrik, tanımlı devir eşikleri, haftalık toplantı takvimi ve ölçümü yapan kişi.
Sonuç
AI müşteri hizmetlerinde kalite güvencesi, botu denetlemek değil, botun ürettiği sonucu görünür ve düzeltilebilir kılmaktır. Doğru rubrik, katmanlı örnekleme, otomatik analiz ile insan kararının birleşimi ve haftalık bir düzeltme döngüsü kurulduğunda yapay zeka hem daha güvenilir hem de daha verimli çalışır. Önemli olan, ilk günden itibaren "hangi sonucu ölçüyorum ve bu sonucu kim düzeltiyor" sorusuna net cevap verebilmektir.
Müşteri görüşmelerinizi tek panelde toplayıp kalite ölçümüne başlamak için Supsis'i keşfedin.